Propojuji historický výzkum, digitální dokumentaci a práci s daty. Zaměřuji se na historické divadelní budovy, prostory pro představení, architekturu a kulturní dědictví.
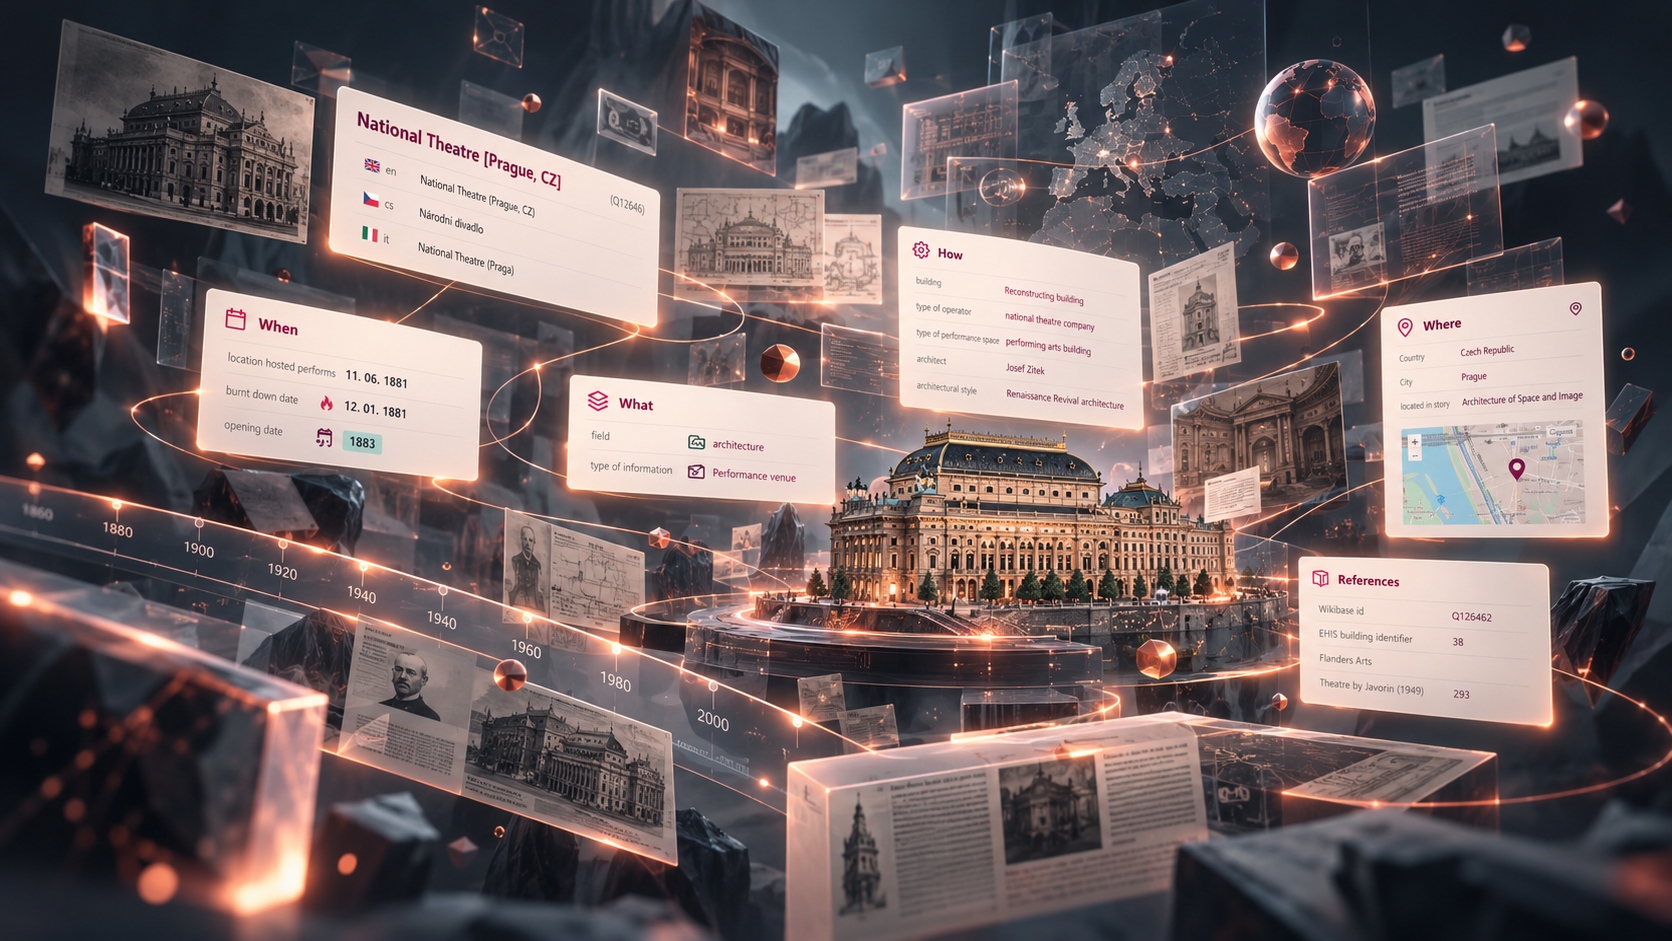
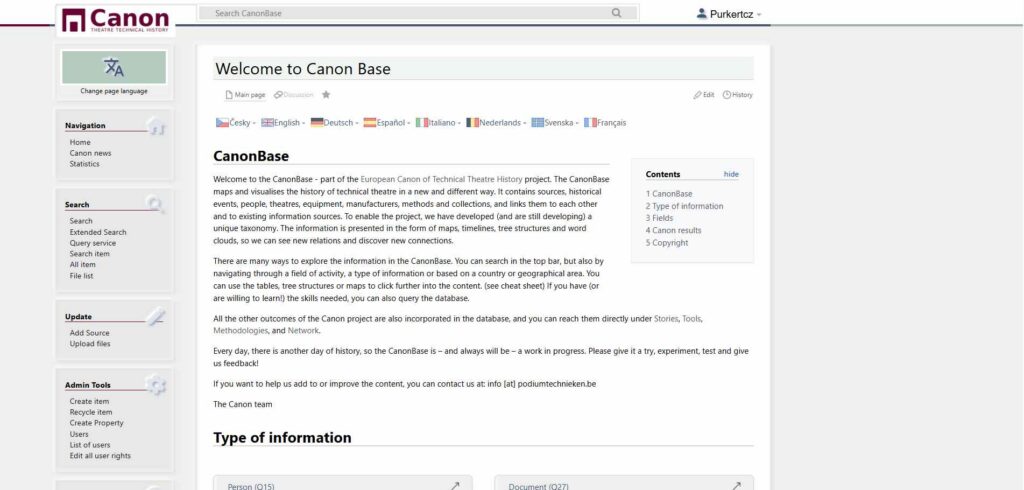
Od archivních pramenů a historických publikací postupuji k ověřeným, strukturovaným záznamům. V prostředí CanonBase, MediaWiki a Wikibase propojuji osoby, místa, budovy, události a dokumenty do znalostních grafů se zachováním odkazů na zdroje.
K historickému výzkumu pro mě patří zvyk klást podvratné otázky, pochybovat i o vlastních závěrech a udržovat v mysli dvě protichůdné teze najednou. Tento přístup mi pomáhá ověřovat zdánlivé samozřejmosti a zůstávat otevřený různým výkladům pramenů.
Pro databázi Divadelní architektura v Evropě (EUTA) jsem připravoval autorské texty o historii divadelních budov a prostorů. Vedle vlastních textů jsem překládal také texty dalších autorů.
Databáze obsahuje více než 35 000 fotografií, často doplněných popisy. Sám jsem pro ni zdokumentoval přes 700 divadel v pěti státech.
Propojuji historický a humanitní výzkum s praktickým vývojem softwaru. Pomáhám navrhovat datové modely, ontologie a znalostní grafy, které dávají výzkumným datům strukturu a umožňují je propojovat, ověřovat a využívat.
Dokážu přecházet od koncepčního modelování k implementaci. Vedle návrhu grafového modelu vyvíjím vlastní nástroje pro transformaci, sjednocování, validaci, dotazování a vizualizaci dat. Opírám se o zkušenosti s programováním, RDF, SPARQL, návrhem ontologií a modelováním výzkumných dat.
Návrh a dlouhodobá údržba datového modelu a ontologie.
Modelování vztahů mezi lidmi, organizacemi, budovami, vybavením, událostmi a dalšími historickými entitami.
Převod výzkumných otázek a odborných pojmů do srozumitelné struktury znalostního grafu.
RDF
Wikibase
Ontologie
02 /
Propojování a kvalita dat
Párování entit s Wikidaty a dalšími autoritními zdroji pomocí PHP, Pythonu a OpenRefine.
Vývoj nástrojů pro odhalování nekonzistencí a validaci dat.
Transformace různorodých datových zdrojů a dotazování nad znalostním grafem pomocí SPARQL.
PHP
Python
OpenRefine
SPARQL
03 /
Nástroje a digitální fondy
Vlastní aplikace pro dotazování, kontrolu a vizualizaci výzkumných dat.
Správa samostatného obrazového a dokumentového repozitáře se strukturovanými metadaty.
Podpora IIIF pro zpřístupňování obrazových dokumentů a jejich propojení s dalšími záznamy.
IIIF
Metadata
Vizualizace
Neveřejný výzkumný projekt
Strukturovaná databáze nebankovních úvěrů
Vyvinul jsem také soukromou strukturovanou výzkumnou databázi, která analyzuje opakující se postupy v nebankovním úvěrování a související právní případy. Databáze samotná není veřejná, protože podkladové materiály obsahují osobní údaje a informace o právních případech.
Významnou část dat jsem získal prostřednictvím OSINT rešerší a strukturovaného vytěžování veřejných zdrojů, včetně insolvenčního rejstříku. Projekt zahrnuje spojování různorodých záznamů, rozlišování a sjednocování identit i vyhledávání opakujících se vztahů a vzorců. Strukturovaná data tak slouží jako podklad pro právní a investigativní výzkum.
Veřejné zdroje · rešerše · strukturovaná data
OSINT & Analýza veřejně dostupných dat.
Od roztříštěných informací ke strukturovaným datům a ověřitelným souvislostem.
Zabývám se systematickým vyhledáváním, zpracováním a analýzou veřejně dostupných informací (Open-Source Intelligence – OSINT). Kombinuji rešeršní a analytickou činnost s vývojem vlastních nástrojů a technologiemi pro práci se strukturovanými daty.
Zaměřuji se na propojování informací z veřejných registrů, soudních rozhodnutí, insolvenčních databází, systémů veřejných zakázek a dalších otevřených zdrojů. Součástí této práce je identifikace a párování subjektů napříč databázemi, analýza jejich vzájemných vztahů a hledání souvislostí, které z jednotlivých záznamů nemusí být patrné.
Veřejně dostupné informace jsou často rozptýlené mezi nesouvisejícími databázemi, dokumenty a informačními systémy. Liší se svou strukturou, terminologií, použitými identifikátory i kvalitou záznamů. Jejich vzájemné porovnávání proto vyžaduje nejen rešeršní práci, ale také systematické zpracování a sjednocování dat.
Pro tyto účely navrhuji datové postupy (data pipelines), které zahrnují získávání informací, jejich vyhodnocování, čištění, normalizaci a převod do jednotných datových struktur.
Využívám relační databáze, RDF, SPARQL a Wikibase k vytváření propojených datových modelů, které umožňují kombinovat informace z různých zdrojů, identifikovat společné entity a analyzovat vztahy mezi nimi.
Výsledkem jsou sjednocená, strukturovaná a vzájemně propojená data, která lze dále prohledávat, analyzovat, vizualizovat a opakovaně využívat. Důležitou součástí je zachování vazeb na původní zdroje, aby bylo možné jednotlivá zjištění zpětně ověřit.
OSINT rešerše a vlastní analytické nástroje
Moje práce propojuje dvě vzájemně se doplňující oblasti:
01 /
Rešeršní a analytická činnost
Vyhledávání veřejných informací, identifikace subjektů, porovnávání záznamů napříč databázemi, mapování vztahů a vyhodnocování zjištěných souvislostí.
02 /
Vývoj nástrojů pro OSINT
Programování vlastních řešení pro získávání, čištění, párování a strukturování dat, automatizaci opakovaných úloh a vytváření databází umožňujících pokročilé dotazování a analýzu.
Tato kombinace umožňuje přistupovat k OSINT nejen jako k jednorázové rešerši, ale také jako k systematickému procesu, jehož výsledky lze průběžně rozšiřovat, aktualizovat a využívat v dalších analýzách.
Transparentnost a ověřitelnost
Při práci kladu důraz na dohledatelnost informací, transparentnost zdrojů a reprodukovatelnost analytických postupů. Rozlišuji mezi ověřenými skutečnostmi, pravděpodobnými shodami a hypotézami, které vyžadují další prověření.
Nehledám pouze informace. Propojuji je, strukturuji a hledám souvislosti, které v jednotlivých zdrojích nejsou na první pohled patrné.
Ve vlastním výzkumném projektu zaměřeném na nebankovní úvěrování a související právní případy propojuji veřejné záznamy, včetně údajů z insolvenčního rejstříku. Různorodé dokumenty převádím do strukturované podoby, sjednocuji identity a hledám opakující se vztahy a postupy. Samotná databáze není veřejná, protože obsahuje osobní údaje a informace o právních případech.
Historical Research & Digital Presentation
Paměť instituce.
Od archivního výzkumu k digitální prezentaci historie.
Nabízím institucím, kulturním organizacím a dalším subjektům komplexní zpracování jejich historie a její převedení do podoby moderního prezentačního webu.
Propojuji historický výzkum, práci s archivními prameny, digitalizaci dokumentů a strukturování informací s návrhem a vývojem webových prezentací.
Výsledkem je přehledná a vizuálně atraktivní digitální prezentace, která může zahrnovat historii instituce, významné osobnosti, časové osy, archivní fotografie, dokumenty, interaktivní mapy nebo tematické databáze.
Historie a kultura na webu
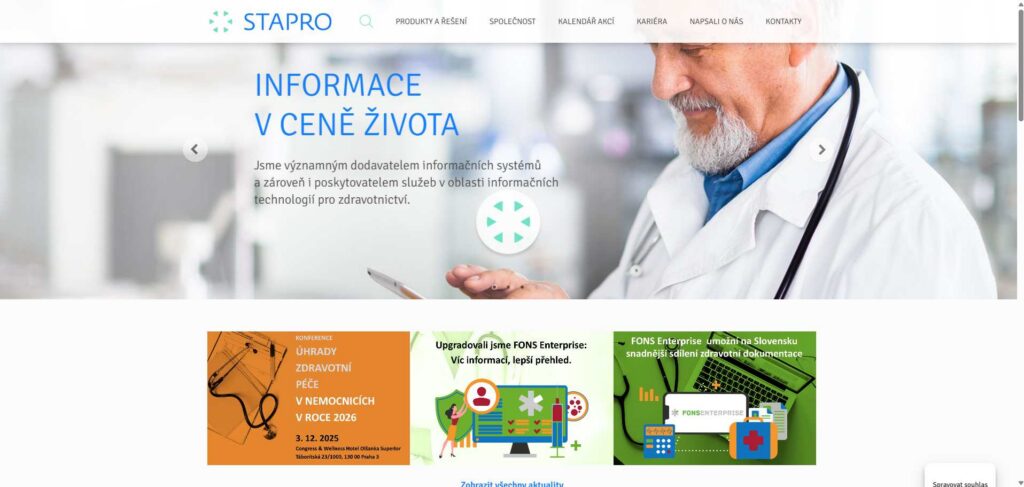
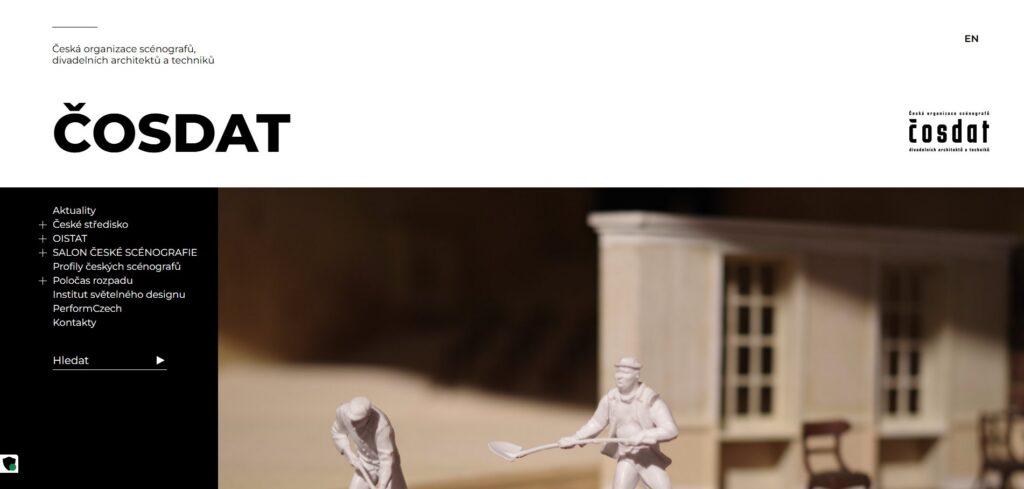
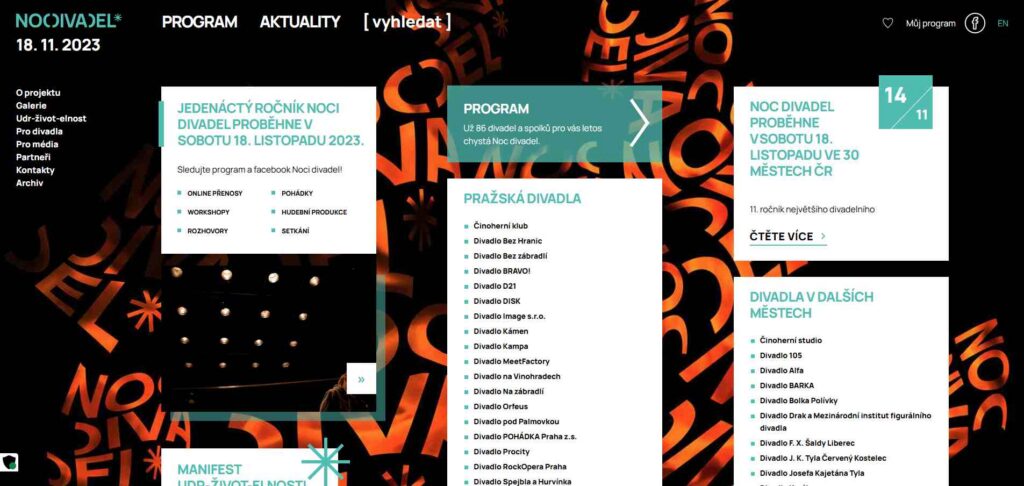
Příklady realizací
Na některých projektech spolupracuji také s archivářem či knihovníkem.
Od backendu a propojených dat po rozhraní, mapy a automatizaci dokumentů. Mám radost z učení, objevování nových souvislostí a hledání postupů, které mohu využít v praxi.
Vlastní aplikace v Reactu nad REST API, SPARQL a strukturovanými daty
Interaktivní časové osy
Hierarchické / stromové vizualizace
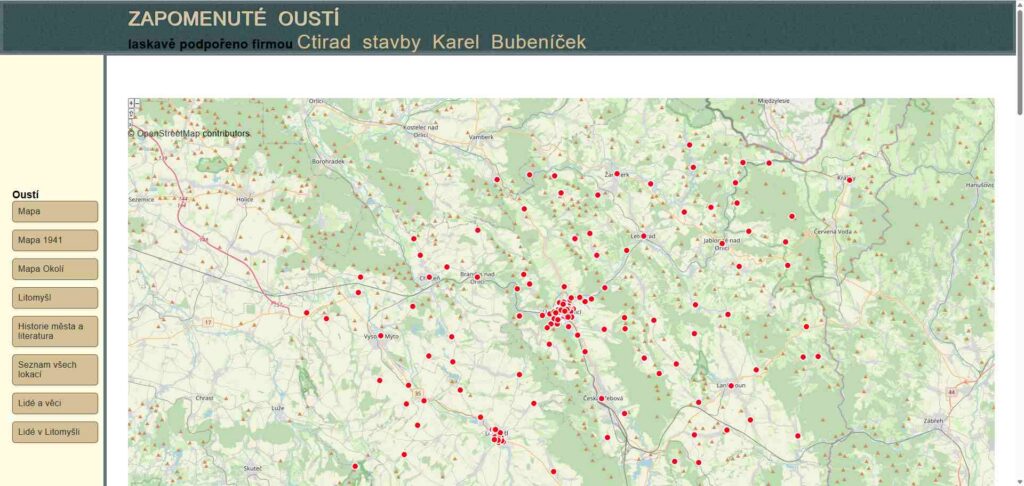
Interaktivní mapy s OpenStreetMap / Leaflet
Využití knihoven
Word dokumenty přes PHPOffice
PDF přes DOMPDF
XML exporty (např. pro Pohoda)
QR kódy přes phpQrcode
WPDF</>XML
01
WordPress weby na míru
Prezentační weby pro firmy
Vytvářím prezentační weby pro živnostníky, firmy, spolky i neziskové organizace. Od mikrostránek až po rozsáhlejší webové prezentace připravené růst společně s projektem.
Specializuji se na převod grafických návrhů do responzivní a uživatelsky přívětivé podoby, která spolehlivě funguje na počítačích, tabletech i mobilních telefonech.
02
Od návrhu k funkčnímu webu
Kódování grafických návrhů
Máte hotový návrh od grafika? Připravím jeho implementaci včetně všech potřebných šablon, komponent a funkcionalit.
Důraz kladu na přehlednou strukturu, rychlost načítání a možnost dalšího rozvoje. Web nebude závislý na desítkách zbytečných pluginů a zůstane dlouhodobě udržitelný.
03
Interaktivní rozhraní · REST API · React
React aplikace propojené s WordPress a MediaWiki
Zaměřuji se na propojování Reactu s databázovými systémy, tvorbu interaktivních uživatelských rozhraní a vizualizaci strukturovaných dat.
Pro projekty, které vyžadují více než běžnou webovou prezentaci, vytvářím interaktivní aplikace v Reactu. WordPress může nadále sloužit jako přehledné administrační prostředí, zatímco React zajišťuje rychlé a uživatelsky přívětivé rozhraní.
React Applications & CMS Integration
React & MediaWiki / Wikibase
ReactMediaWiki APIWikibaseSPARQL
Interactive interfaces for structured data
Linked Open Data visualization
Entity relationships – React Flow, Dagre
Geographic data visualization – Leaflet
MediaWiki / Wikibase↔API / SPARQL↔React
W
React & WordPress
Custom Gutenberg blocks and React components
WordPress REST API integration
Interactive frontend components
Custom WordPress themes and plugins
GutenbergREST API
Data & Document Integration
MediaWiki API, WordPress REST API
CanonBase ↔ WordPress data integration
Document retrieval and structured data linking
PHPMySQLJSON
Výkon a zabezpečení
Optimalizace, monitoring, odstraňování chyb
Externí služby
REST API, Fakturoid, Google Drive, Pohoda
Mapové aplikace
Google Maps, OpenStreetMap
Vícejazyčné weby
Polylang, překlady, mezinárodní projekty
Řešení na míru
Vývoj a přizpůsobení webových aplikací specifickým požadavkům.
Pokud standardní šablony, pluginy nebo hotová řešení nestačí, navrhuji a vyvíjím vlastní funkcionality podle konkrétních potřeb projektu. Ať už jde o rezervační systém s nestandardními pravidly, automatizaci procesů, propojení externích služeb nebo specifické nástroje pro správu dat.
Technologie přizpůsobuji potřebám projektu, nikoliv naopak.
Kontakt · Jan Purkert
Jsem programující historik.
Vystudoval jsem historii a přes spolupráci s paměťovými institucemi a edukačními projekty se dostal k databázím a programování.
Díky kombinaci humanitního vzdělání, jazykové vybavenosti a technických znalostí stavím od roku 2017 moderní a rychlé weby, které dlouho vydrží. Specializuji se na WordPress a MediaWiki.
10+
Let zkušeností
s WordPressem
100+
Realizovaných webů
a aplikací
100 000+
Editací na Wikidatech
(pro odborné projekty)
1
Kontaktní osoba
Přímá spolupráce od návrhu po dokončení
Předvolby cookies
Soukromí na tomto webu
Pouze nezbytné cookies
Web používá pouze nezbytné cookies pro základní fungování, například pro nastavení jazyka. Analytické ani marketingové cookies nepoužívám a nesbírám data pro sledování návštěvnosti.
Nezbytné cookiesVždy aktivní
Tyto cookies zajišťují základní funkce webu a nelze je v těchto předvolbách vypnout.